

Gambaran Layanan Rekayasa AI:
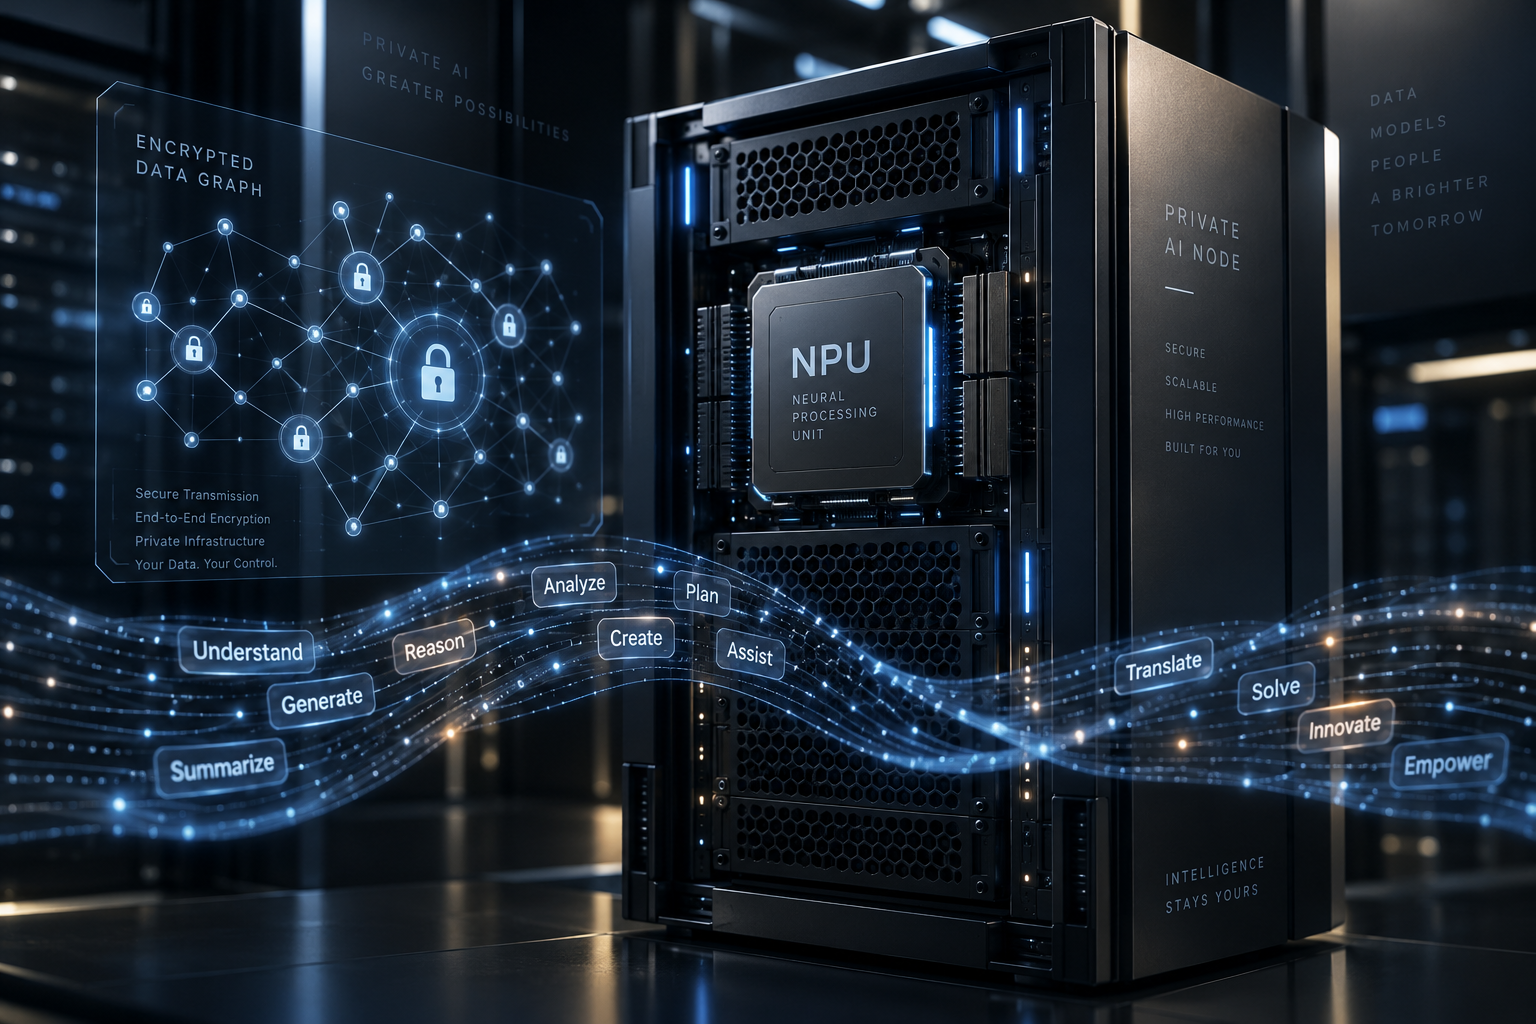
Layanan On-Premise LLM & Private AI kami menyediakan solusi rekayasa kecerdasan artifisial end-to-end yang berjalan sepenuhnya di server internal enterprise. Kami mengintegrasikan fondasi model open-weights berkinerja tinggi (Llama 3, Qwen 2.5, DeepSeek) dengan pipeline Retrieval-Augmented Generation (RAG) terakselerasi dan engine database vektor Qdrant. Seluruh data sensitif, dokumen kepatuhan, dan histori operasional diproses secara air-gapped di GPU cluster lokal tanpa pernah terkoneksi ke API cloud publik pihak ketiga.
Cakupan Rekayasa & Implementasi Sistem:
Kami menerapkan standar arsitektur komputasi mutakhir mulai dari inferensi vLLM / TensorRT-LLM berlatensi rendah, fine-tuning LoRA adaptif pada dokumen domain industri, hingga antarmuka AI asisten yang terintegrasi aman dengan database internal Anda.
Discovery & Strategy:
- Initial consultation to understand your business, goals, and target audience.
- Competitor analysis and market research.
- Defining website objectives and key performance indicators (KPIs).
- Sitemap creation and user flow planning.
User Experience (UI/UX) Design:
- Wireframing to outline the website structure and layout.
- User journey mapping to optimize navigation and interaction.
- Usability testing (where applicable) to ensure an intuitive experience.
- Visual design of all web pages, including typography, color palette, and imagery.
Your vision, our expertise.
Discover how our integrated approach to design and development can revitalize your brand image, engage your audience, and drive growth.
Ingin Mengembangkan Solusi Web & AI di Organisasi Anda?
Diskusikan Kebutuhan Anda Bersama Insinyur SAI Tech


